 echolabs
ECHO-5.5-v1 · aceptación funcional CPU
Fecha: 16 de octubre de 2026. Rama research/echo-5.5-arc3.
Verde funcional v1; ventaja científica en ARC todavía no evaluada.
GPU/Kaggle consumidos en este trabajo: 0 h. El servidor local se detuvo al terminar.
Qué se implementó
Un modelo externo genera mini-programas Python con bucles y funciones. El código se compila en un hijo aislado con Bubblewrap y cgroup v2; el padre conserva el juego, las claves, el contador monotónico y la autorización de cada acción. No se ha integrado ni copiado el arnés completo de Duck: se implementa el patrón de ejecución de programas como base para un contraste posterior.
Se reutilizan ReceiptStore, la CAM existente, la segmentación de SEED y
HypothesisAgent.plan. No se añade un LLM a NEXUS-0 ni un segundo thought bus.
thought.jsonl usa echo5.trace.Recorder y registra eventos reales observables.
La API incluye observación, acciones/clics, ejecución de secuencias, componentes, deltas, candidatos de agencia/contacto y planificación condicionada. El contexto conserva política y último frame completo mediante RLE sin pérdida; desaloja bloques antiguos enteros. El conteo de entrada usa la plantilla real del servidor y los mismos IDs que se envían a inferencia. Una reserva de uso desconocido se carga íntegra, sin repetir automáticamente la llamada.
Resultados medidos
| Prueba | Resultado | Alcance |
|---|---|---|
| Tests nuevos de v1 | 29 pasados | IPC, aislamiento, cuotas, terminalidad, efectos parciales, percepción, memoria, contexto y proveedor |
| Interacción existente | 24 pasados | Planificación y motor reutilizados |
| CAM/núcleo y actualización de rejilla | 9 pasados | Regresión seleccionada |
| Benchmark sintético scriptado | 6/6 casos resueltos | Corredores de 3, 5 y 9 movimientos; dos interfaces |
| Modelo real CPU, corredor de 3 pasos | 1/1 resuelto; 1 llamada; 592 tokens | Qwen genera y ejecuta el programa, sin solución escrita por el operador |
| Smoke oficial offline | 2/2 ejecuciones válidas; 24 acciones; 0 niveles y 0 victorias | Transporte/API oficiales, no capacidad de resolución |
Total: 62 pruebas seleccionadas, no una reejecución de toda la suite histórica.
Los tres runs finales comprobaron que sus fuentes no cambiaron durante ejecución.
Sus 180 recibos se verificaron con custodia HMAC local; diarios de observación
válidos, destroyed == 0 y trabajos del sandbox vacíos al finalizar.
Lo que demuestra el benchmark scriptado
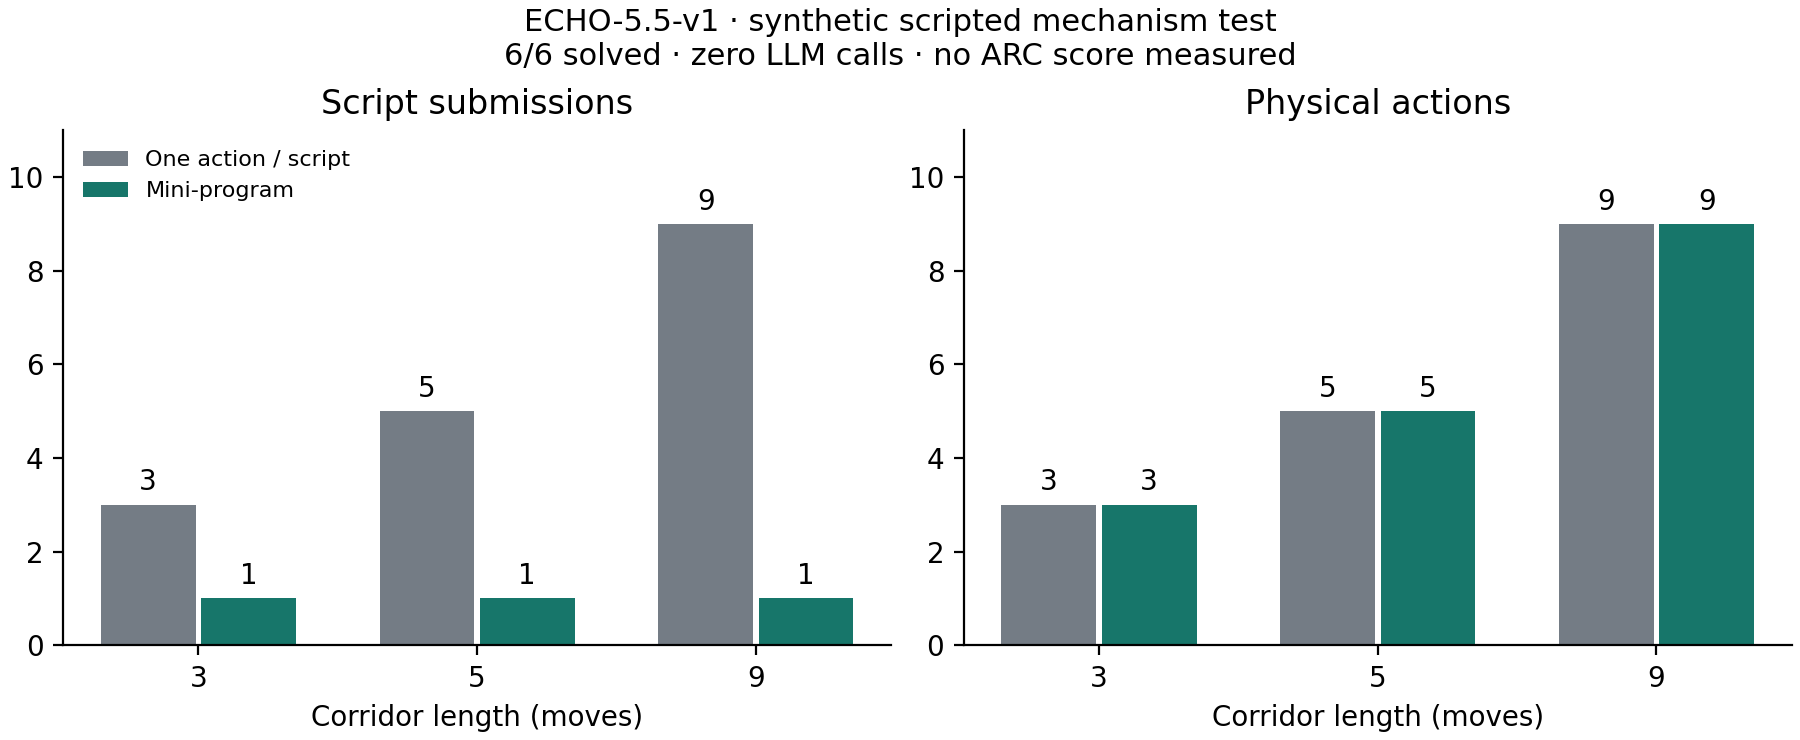
Ambas variantes realizan 17 movimientos en total y resuelven sus tres corredores. El control necesita 17 envíos de script; la variante de mini-programa necesita 3: 82,35 % menos envíos, con idéntico número de acciones físicas. Son scripts del operador: 0 llamadas LLM, sin ahorro de tokens medido y sin evidencia de ventaja de resolución. Es una comprobación del mecanismo de batching.
Modelo real
Qwen2.5-Coder-7B-Instruct, Q4_K_M, GGUF SHA-256
509287f78cb4d4cf6b3843734733b914b2c158e43e22a7f4bf5e963800894d3c.
llama.cpp d230ddd, contexto 4096, cuatro hilos, cero capas GPU, temperatura 0,
semilla 73. La calibración final tardó 115,46 s: 407 tokens de entrada y 185
de salida, tres acciones y una llamada. El modelo programó un bucle que
localiza los colores declarados por el fixture y se mueve hasta terminal.
No utilizó el planificador; esta prueba no atribuye al helper la resolución.
Antes de aclarar la API, dos programas repitieron echo.terminal, atributo
inexistente, y no realizaron acciones. La tercera generación agotó el timeout
de 180 s; la siguiente instancia se interrumpió. Se conservan las reservas y
los errores en intentos de desarrollo.
Se explicitó echo.observe()['terminal'] y se ajustó el timeout local a 300 s.
La ejecución final usa un directorio nuevo, no sustituye ni borra esos fallos.
Solo se calibró finalmente el corredor de 3 pasos; no se infiere 3/3 con LLM.
Resultado y fuente generada · Identidad del modelo.
Entornos oficiales
arc-agi==0.9.3, arcengine==0.9.3, modo OFFLINE, juegos públicos de desarrollo
bp35-0a0ad940 y s5i5-18d95033. Doce acciones por juego, incluyendo soporte
de clics; reset inicial separado. El código generado no recibe el objeto interno
del juego. El hash de los archivos de entorno está en el resultado.
El primer smoke descubrió una incompatibilidad de construcción de GameAction;
se corrigió usando la API GameAction.from_id y se repitió en una salida nueva.
No hubo victorias. No se calculó puntuación oficial ni se envió nada a Kaggle. Resultado · Dependencias observadas.
Seguridad y límites prácticos
El hijo no monta el repositorio, /home, secretos ni juego, y tiene namespace de
red separado. Solo monta /usr de lectura y su bootstrap/código/observación.
Por ello el runtime es dependiente del host, no un rootfs hermético reproducible.
Límites por defecto: 128 MiB, sin swap, 16 tareas, 2 s de CPU, 5 s de ejecución,
16 KiB de código y 64 KiB de salida; el arranque tiene un plazo independiente.
El canal valida acciones, clics, IDs, orden y presupuestos; nunca acepta la
afirmación del hijo como prueba de victoria. Se comprueba el cierre del cgroup.
Los efectos ya ejecutados persisten tras error o timeout: no hay rollback del
mundo. Una excepción durante un efecto deja su estado como incierto e impide
seguir actuando. Los IDs evitan duplicados dentro del snippet; no se promete
recuperación automática de una campaña tras una caída completa del padre.
El motor del juego corre como código confiable y síncrono en el padre: este v1
no proporciona un watchdog capaz de interrumpir cualquier env.step bloqueado.
El planificador existente es búsqueda condicional en mapas de 2..16 por eje; se abstiene en frames ARC de 64×64 sin una abstracción válida. No se anuncia A* universal ni mínimo global en física desconocida. El mapa y la relación acción/desplazamiento son precondiciones explícitas, no descubrimientos ciertos.
No-op no es pared. Un veto solo se habilita con contrato estable explícito del adaptador y coincidencia exacta de observación/acción/contexto; ARC no lo declara y permanece advisory. La memoria se puede revocar. Agencia y contacto son hipótesis basadas en cambios, no roles ni causalidad demostrados. Los componentes y deltas tienen límites de salida y señalan truncación; el frame base no se trunca.
Checklist de v1 y siguiente contraste
- Python generado en hijo; autoridad exclusiva del padre.
- Cuotas persistentes entre programas y parada antes de acciones extra.
- Evicción, conteo completo de tokens y reserva conservadora ante interrupción.
- Percepción, hipótesis temporales, planificación reutilizada y memoria revisable.
- Pruebas CPU, benchmark simple y generación real con modelo local.
- Adaptador oficial offline y cierre de procesos/recibos.
- Gráfica, datos, hashes y comandos reproducibles sin publicar claves.
- Abstracción píxel/celda y aprendizaje contextual de actuadores para mapas grandes.
- Episodios de resolución oficiales con modelo, presupuestos y juegos fijados.
- Baseline Duck compatible y licencias fijadas; ablaciones sin planificación/memoria.
- Contraste pareado de acciones, niveles, victorias y tokens; sin asumir mejora.
- Calibración GPU si aporta algo al siguiente experimento; Kaggle sigue sin usarse.
Este resultado permite continuar con el piloto oficial. No cierra ARC, ni demuestra superioridad sobre Duck, ni certifica una reducción de alucinaciones del modelo.