 echolabs
ECHO-5.5-v2 · niveles oficiales, alcance y límites
16 de octubre de 2026. Estado: integración CPU con progreso oficial verificado; ventaja del LLM y cierre competitivo pendientes. Se conservan los resultados de v1.
Resultado principal: tres juegos, condiciones pareadas
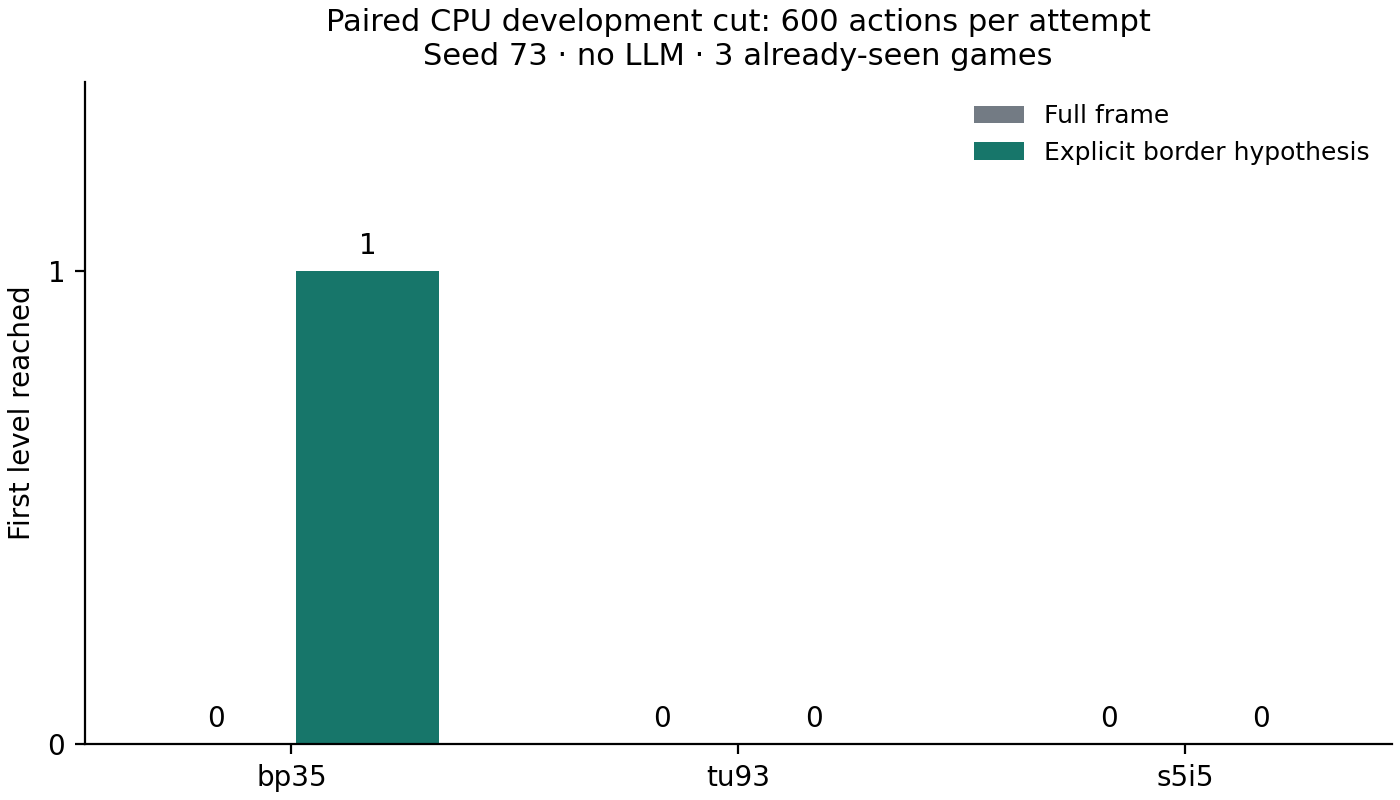
Antes de ejecutar se fijaron tres juegos públicos ya conocidos, semilla 73 para entorno y política, 600 acciones físicas por intento, y parada en el primer nivel. Se comparó el mismo explorador, con frame completo o máscara de borde explícita. Ambas condiciones usan clics dirigidos a componentes: este contraste cambia la clave de estado, no simultáneamente el método de selección de clics.
| Juego | Frame completo | Máscara de borde |
|---|---|---|
| bp35-0a0ad940 | 0 niveles / 600 acciones | 1 nivel / 247 acciones |
| tu93-0768757b | 0 / 600 | 0 / 600 |
| s5i5-18d95033 | 0 / 600 | 0 / 600 |
0/3 frente a 1/3 en este corte de desarrollo, sin LLM. No es una demostración estadística de superioridad general, ni un examen reservado, ni puntuación Kaggle. La máscara puede eliminar información útil además de HUD; se trata como hipótesis.
JSON completo · Plan fijado · PDF.
Reproducciones adicionales: el circuito nuevo conserva las victorias
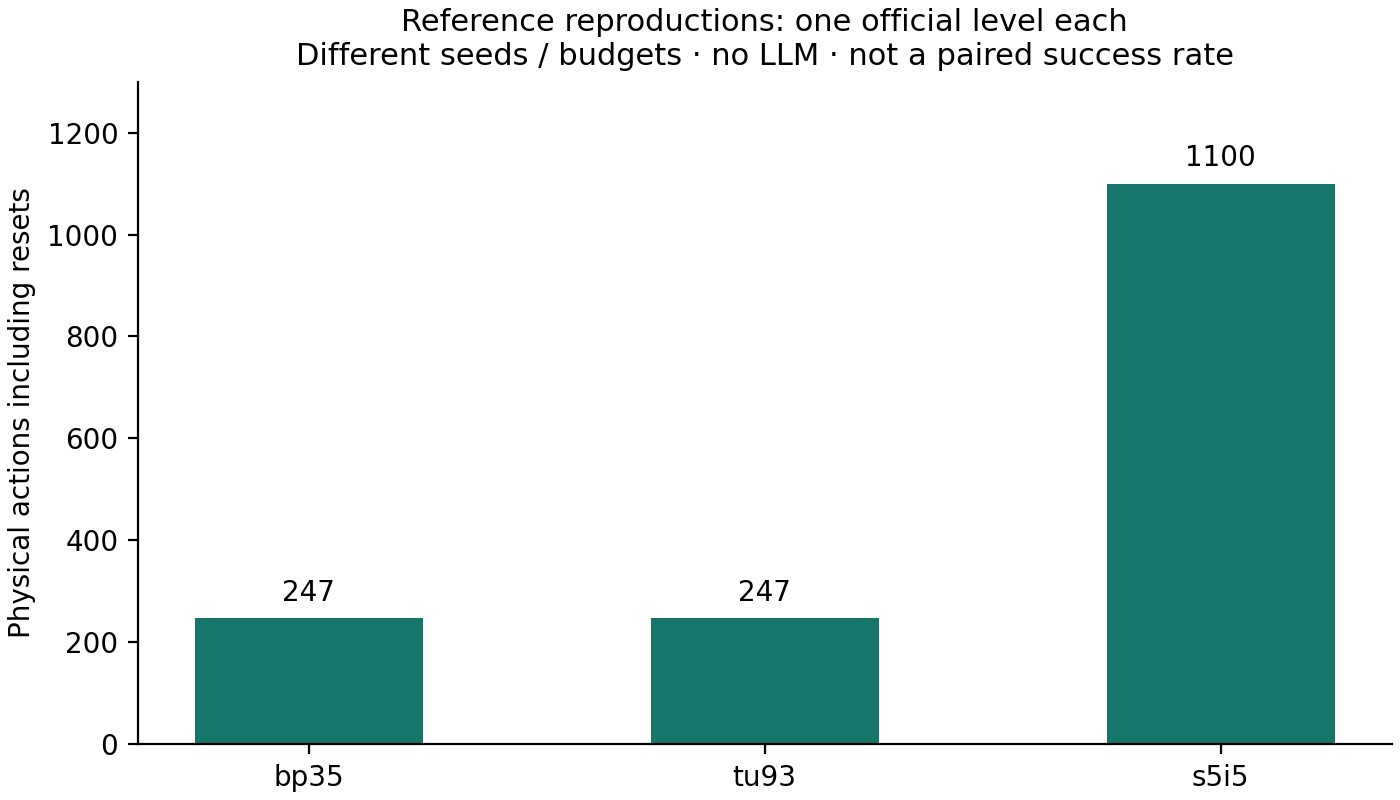
La referencia antigua se ejecutó como diagnóstico público con el motor actual. Con semilla 73, S5I5 necesitó 1.100 acciones para avanzar y TU93 no avanzó en 2.000. Con la semilla histórica, TU93 volvió a alcanzar cuatro niveles. Esas observaciones motivaron reproducciones separadas: no se mezclan con el panel 600.
| Juego | Semilla política / entorno | Cuota | Acciones hasta nivel 1 | Resets incluidos |
|---|---|---|---|---|
| bp35 | 73 / 73 | 600 | 247 | 3 |
| tu93 | 1336611269 / 0, histórica | 600 | 247 | 4 |
| s5i5 | 73 / 73 | 1.200 | 1.100 | 21 |
Las tres pasaron por el hijo Bubblewrap y el padre de v2, con echo.explore().
Se alcanzó levels_completed == 1; no se completó el juego entero.
Las fuentes permanecieron intactas en cada reproducción. Corte de código local:
1c47718, antes de la mejora posterior de proyección cortical.
Esto reproduce capacidades conocidas bajo condiciones concretas. No atribuye una mejora a A*, al LLM ni a memoria nueva entre tareas. No se entrenó un modelo.
Datos JSON · CSV · PDF.
Repeticiones de victorias reales
Los GIFs contienen cada observación pública, incluidos resets y transición de nivel. No son smoke tests ni animaciones inventadas. La cadencia es de presentación; no mide tiempo de ejecución ni implica una estrategia humana comprensible. El contador muestra las acciones acumuladas y los niveles observados por el SDK.
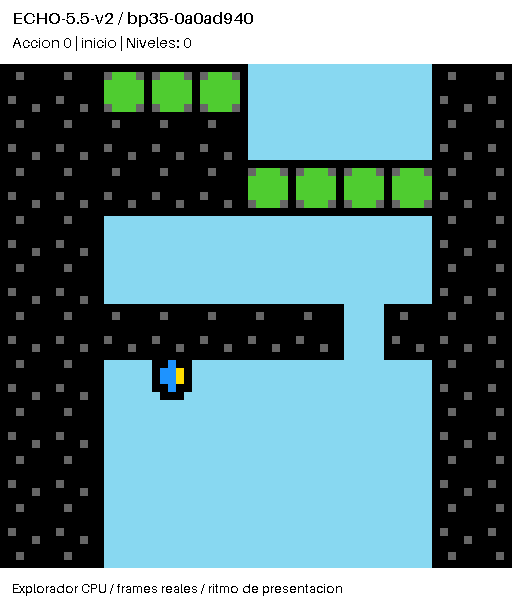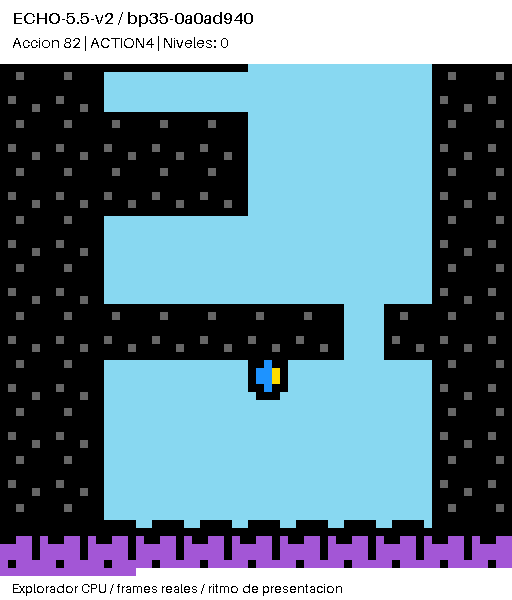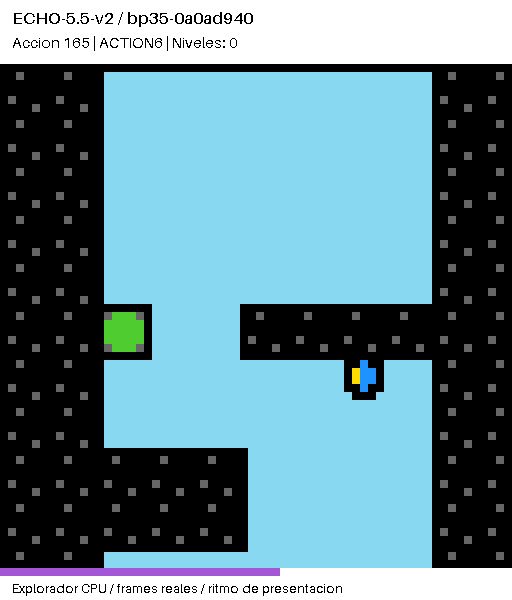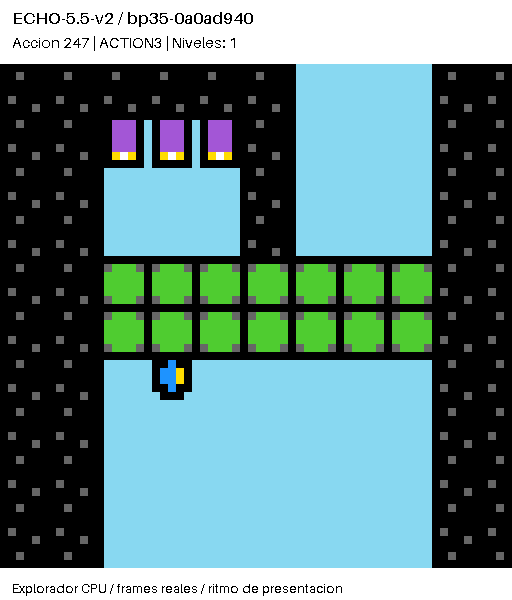
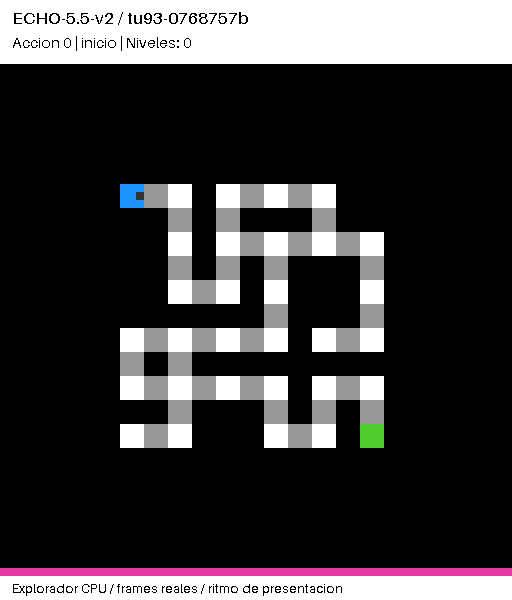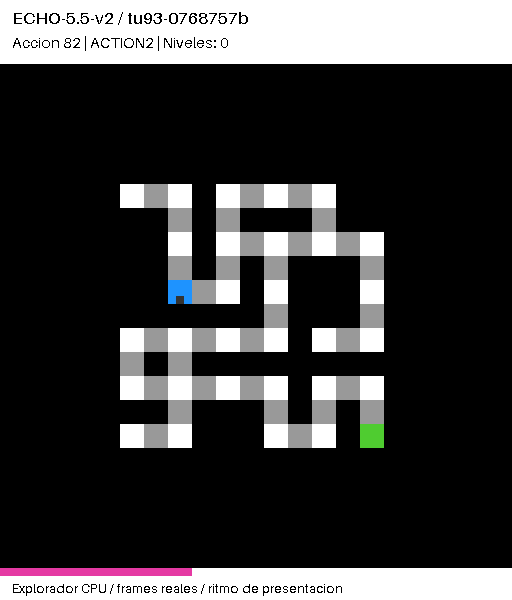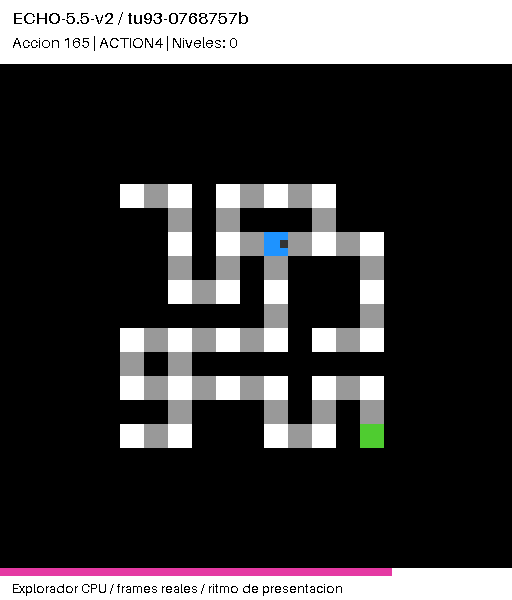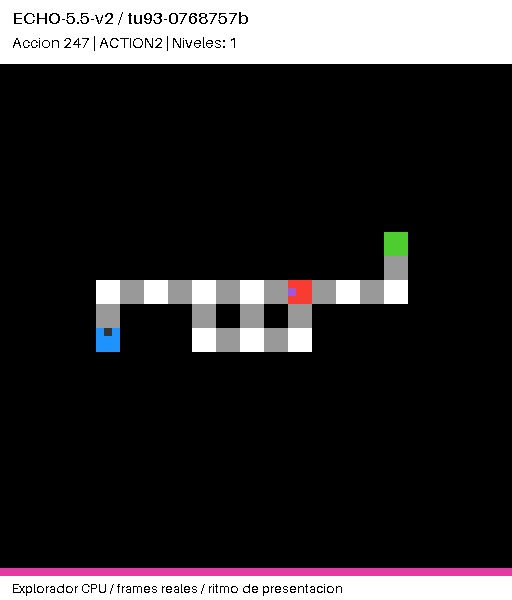
Hay capturas iniciales/finales, timelines y un ZIP público por juego junto a los GIFs. Los ZIP incluyen recibos, catálogo firmado, blobs de frames, plan y scorecard; excluyen autoridades y claves HMAC. La autenticación se validó localmente con custodia privada. El SHA-256 de cada frame está anclado en el recibo; una firma no certifica que una interpretación cognitiva sea verdadera.
Las reproducciones suman 5.005 recibos de eventos y 80 recibos de catálogo,
con diarios válidos, frames comprobados, destroyed == 0 y cgroups cerrados.
Se verificó el número de frames de los GIFs y su coloración en cuatro cortes
por juego, incluido el frame final, con la paleta oficial de arc-agi 0.9.3.
Qué cambió en el código
- A* acotado a 4.096 celdas, rutas cardinales de coste unitario, hasta 64×64.
Solo es óptimo bajo el mapa y los efectos declarados; no interpreta la física
del juego.
action_map=[arriba,derecha,abajo,izquierda]declara los IDs. echo.targets(background=None)devuelve componentes por rareza de color, con el centro proyectado a una celda observada. Son candidatos, no metas ciertas.echo.explore(steps)delega en la política históricaArc3EchoV2, importada, no copiada. Su T, curiosidad BFS, estimación de efectos y rutas se conservan.- La política comparte la CAM activa del broker. No se introduce un LLM en NEXUS-0 ni otro bus de pensamiento. Las rutas se invalidan ante contradicciones.
- La clave exploratoria admite máscara de borde opt-in. La observación original y la clave de seguridad conservan el HUD; nunca se recorta el frame del hijo.
- Muertes son observaciones con atribución tentativa. Supervivencia previa
revoca el veto tentativo, pero no demuestra que la muerte sea por energía.
El guard de muerte es opt-in (
--death-guard) y estuvo apagado en los contrastes publicados. Una supervivencia posterior también elimina la marca tentativa de la política histórica. - Reset es una capacidad explícita después de GAME_OVER confirmado y consume una acción. No se reinician las cuotas al cambiar de programa ni hay rollback del mundo. Las peticiones se deduplican dentro del script.
Se resolvió además un cuello de botella de auditoría: frames por hash y segmentos pequeños del ReceiptStore existente, unidos mediante catálogo HMAC. El catálogo mantiene orden global y ancla la cabeza de cada segmento anterior. Los blobs se verifican contra sus hashes; falta de autoridad, truncación, sustitución o segmentos no registrados causan fallo. No se cambió el núcleo de recibos congelado de 5.1. Los intentos previos interrumpidos por coste se mantienen en artifacts/v2-development.
Preparación y prueba del neocórtex
El tokenizador local de Qwen 7B detectó que el RLE inicial de BP35 superaba el límite de 3.000 tokens. Se añadió un diccionario de filas sin pérdida: los índices seleccionan filas RLE únicas. En el corte medido pasó de 3.182 a 2.259 entradas; TU93 de 2.061 a 1.074 y S5I5 de 1.624 a 1.118. Es proxy de familia, no medición certificada del 32B. El proveedor objetivo hace su propio conteo antes de generar.
También se corrigió un fallo de observabilidad: print() se capturaba, pero el
turno siguiente no recibía esa salida. Ahora recibe un extracto acotado y marcado,
sin convertir texto del modelo en hechos. Las pruebas verifican que una salida
calculada en el hijo llega al siguiente turno y que el límite de tiempo se impone
antes de una acción extra. Una meta de nivel se reporta por separado de WIN.
Calibraciones reales con el 32B en Kaggle
Qwen2.5-Coder-32B-Instruct Q4_K_M, revisión
9d3053fce650fe1cdbdb75998c2a87add9d178ef, SHA-256
4d64b316b5e6319d9613e0d97935d9ebd631fc7e334da400d00085eca749d085.
Se verificaron 65/65 capas en GPU en dos Tesla T4. El juego y los candidatos
Python se ejecutaron en el host local aislado; Kaggle solo sirvió inferencia.
| Calibración | Niveles alcanzados | Acciones | Llamadas | Tokens |
|---|---|---|---|---|
| R1, primer protocolo | 0 | 64 | 1 | 2.309 |
| R2, continuidad corregida | 1 | 247 | 4 | 10.318 |
R1 emitió un bucle de clics al centro hasta GAME_OVER. Se conserva ese fracaso. El runner determinista permitía resets, pero el bucle cortical terminaba al perder una vida. R2 habilita continuidad tras GAME_OVER en la misma cuota, una directriz explícita de exploración cuando no se conocen las reglas y corte de llamadas al agotar acciones. Se verificó en CPU que el reset final no dispara una generación pagada cuando consume la última acción disponible.
En R2 los cuatro programas fueron echo.explore(steps=64). El padre hizo tres
resets y paró al primer nivel. La secuencia de 247 acciones y los 248 frames
coinciden exactamente con la referencia CPU. El LLM pudo orquestar el explorador;
no mejoró su ruta ni descubrió por sí mismo la solución, y añadió 10.318 tokens.
R1 y R2 son calibraciones adaptativas con protocolos diferentes, no un contraste
causal que separe el efecto de cada cambio.
Cada intento tenía como techo ocho llamadas, 25.000 tokens, 600 acciones,
3.000 entradas/512 salidas por llamada y 30 s por programa. Los prompts iniciales
reales fueron 2.276 y 2.319 tokens. Ambos cortes conservaron sus fuentes sin
cambios, recibos y frames válidos, destroyed == 0, cgroups cerrados y ninguna
reserva de generación sin respuesta. WIN completo sigue siendo falso: se ganó
un nivel, no todo el juego.
Los dos kernels privados terminaron en COMPLETE y se cerraron relays/túneles. Entre los envíos y las solicitudes de parada transcurrieron unos 16,1 minutos en total, incluyendo arranque/descarga. No es una lectura de facturación ni un saldo certificado de Kaggle. Se consumieron 12.627 tokens de inferencia.
Resumen y coincidencias · R1 y programa fallido · R2 y sus cuatro programas · Perfil GPU verificado.
El protocolo exacto de cada corte está preservado como texto y coincide con el hash de su plan. La CLI posterior añade una entrada reusable y amplía el manifiesto de dependencias; no reescribe los datos de calibración. No se lanzó el panel de 25 juegos: todavía falta fijar un baseline Duck compatible y un contrato de ablaciones que evite atribuir al modelo las victorias de la exploración CPU.
Verificación y lo que falta
50 pruebas de v1/v2, 24 de interacción y 9 del núcleo/rejilla: 83 pasadas. Las pruebas históricas de v1 permanecen como datos; se actualizó el contrato actual que antes esperaba abstención del planificador en 64×64.
- Helpers 64×64, candidatos, exploración y memoria por nivel integrados.
- Niveles oficiales alcanzados desde el hijo y auditados por el padre.
- Contraste CPU pareado y fallos preservados.
- Proyección cortical y feedback comprobados antes de generar remotamente.
- Calibración 32B cerrada y auditada; sin ventaja sobre la ruta CPU observada.
- Panel de 25 juegos con políticas, cuotas y scorer congelados y ablaciones.
- Comparación LLM solo / LLM+ECHO / ECHO solo a recursos declarados.
- Entrada Kaggle autosuficiente sin internet; el relay de desarrollo no sirve como submission oficial. Bubblewrap/systemd del host no se presuponen en Kaggle.
- Mejoras de percepción/actuadores y transferencia con evidencia independiente.
- Cierre competitivo y paper. No se declara verde científico por estas reproducciones.
El scorer del SDK se guarda, pero sus números locales no son una puntuación de leaderboard. El premio exige una submission vinculada al paper. La fecha oficial es 2 de noviembre para código y 8 para papers; los fondos anunciados no son una recompensa garantizada para el laboratorio. Calendario · Requisitos del Paper Prize.