 echolabs
Responder menos para equivocarse menos: el examen SimpleQA
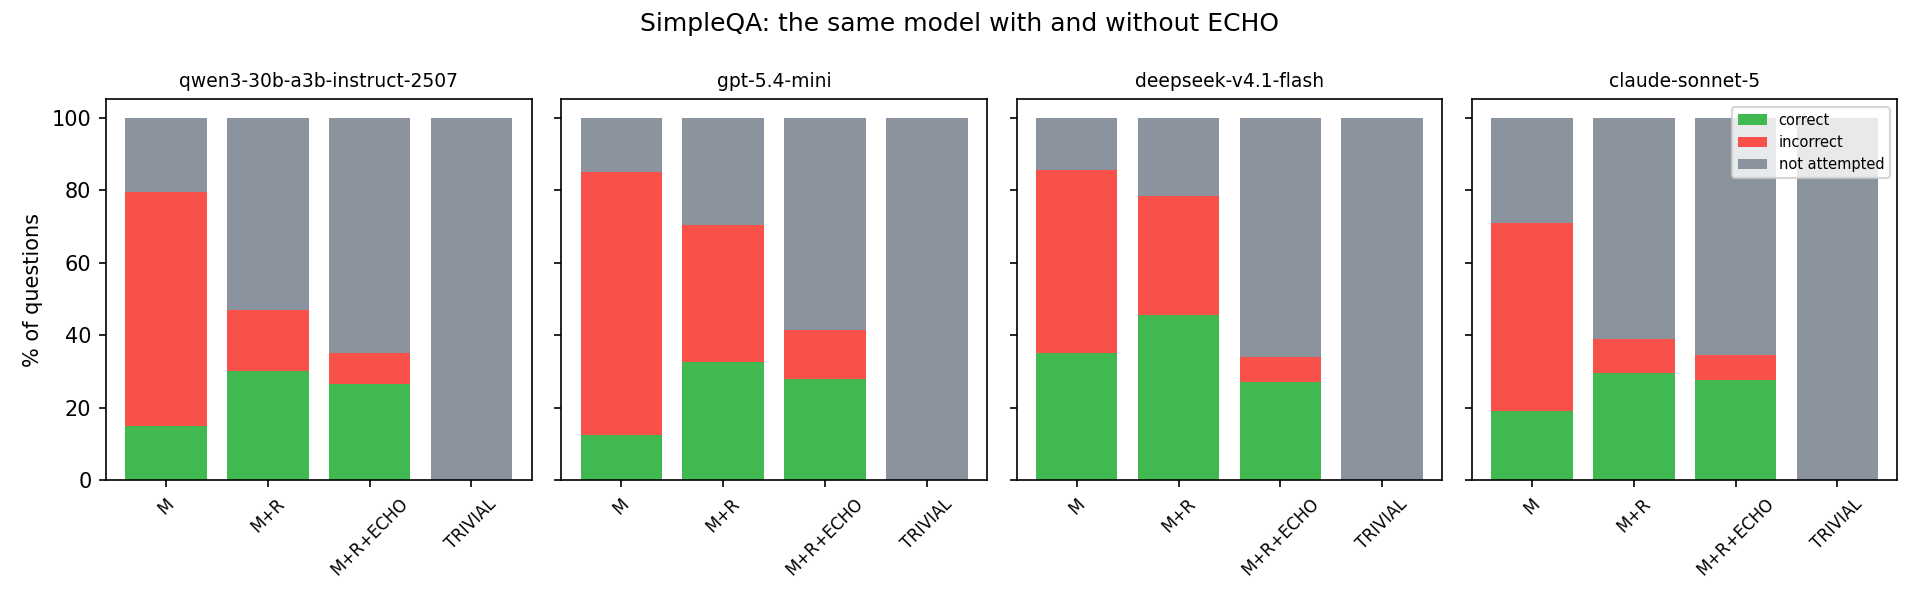
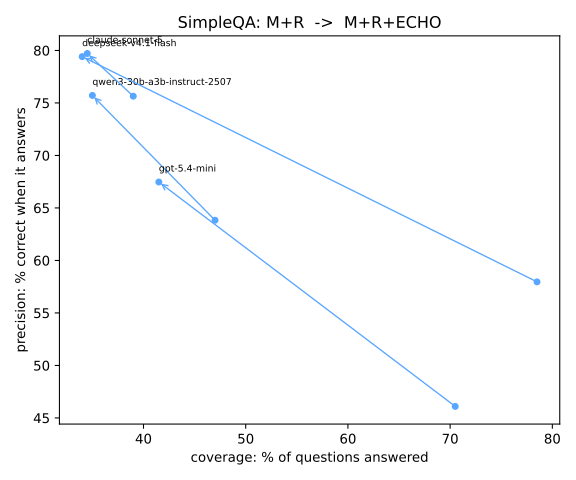
200 preguntas por modelo: menos respuestas incorrectas en cuatro modelos, con un coste de cobertura declarado.
Las gráficas originales
La pregunta que medí
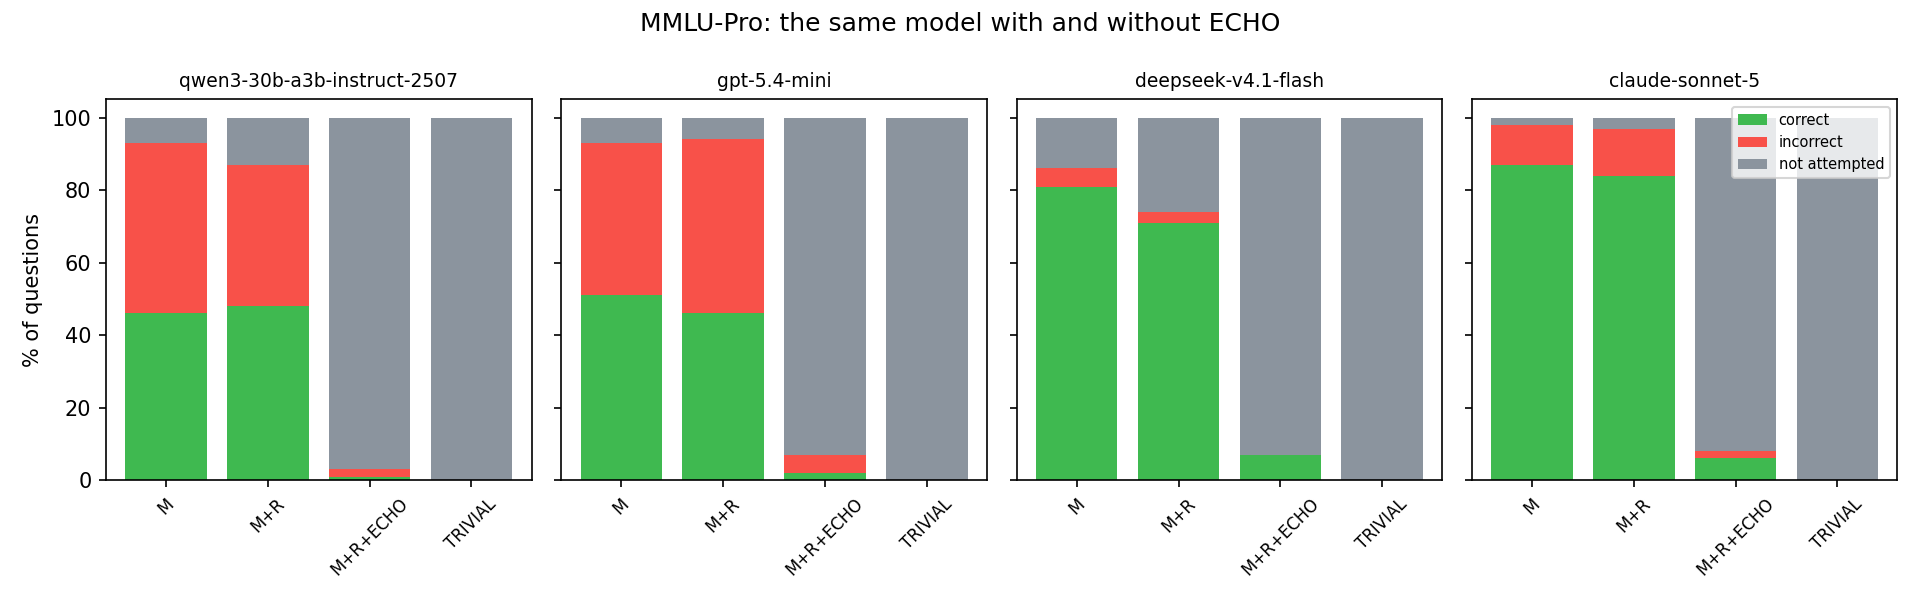
Quise separar el conocimiento del modelo del efecto de aportar evidencia y del efecto de filtrarla. Comparé M, modelo solo; M+R, modelo con extractos de Wikipedia; y M+R+ECHO, los mismos extractos con el cortafuegos. El examen congelado incluyó 200 preguntas de SimpleQA, 100 de MMLU-Pro y 50 de GSM8K por modelo. El registro conserva un coste de 1,55 dólares y una auditoría válida reconstruida sin nuevas llamadas.
| Modelo registrado | Incorrectas M → M+R → ECHO | Correctas M+R → ECHO |
|---|---|---|
| Claude Sonnet 5 | 104 → 19 → 14 | 59 → 55 |
| DeepSeek-V4.1-Flash | 101 → 66 → 14 | 91 → 54 |
| GPT-5.4 mini | 145 → 76 → 27 | 65 → 56 |
| Qwen3-30B-A3B-Instruct-2507 | 129 → 34 → 17 | 60 → 53 |
Estos son los nombres e IDs conservados por el informe histórico, no una nueva evaluación de esos proveedores. El JSON enlazado conserva los identificadores completos.
Qué salió bien y qué costó
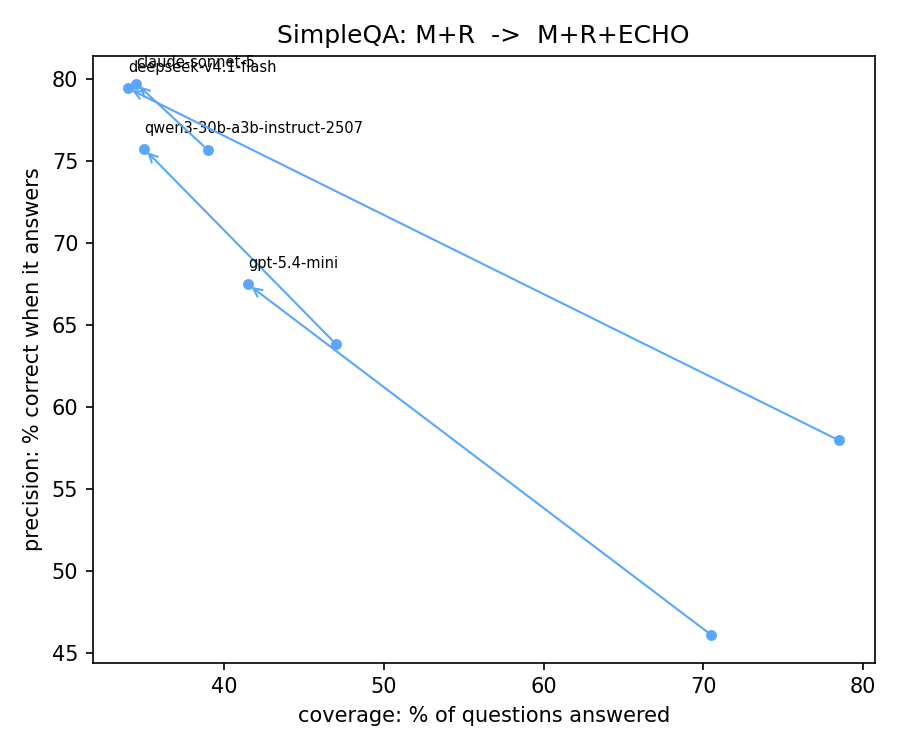
Frente a M+R, ECHO redujo incorrectas y elevó la precisión de las respuestas emitidas en los cuatro modelos. No creó ningún acierto: su función era aceptar o abstenerse. También perdió respuestas correctas; el F-score bajó en tres modelos y subió en GPT-5.4 mini. Es evidencia de filtrado selectivo en este banco, no de mayor capacidad general ni de ausencia de alucinaciones.
Los controles negativos
En MMLU-Pro se abstuvo casi siempre y el cotejo textual dejó pasar opciones equivocadas. En GSM8K se abstuvo en las 50 preguntas de cada modelo: no podía verificar cálculos con extractos. El corrector era determinista, distinto del juez LLM de SimpleQA; estas cifras no equivalen a un resultado oficial del benchmark.