 echolabs
Ocho llamadas y ninguna victoria: qué reveló BP35 R2
La representación ya cabe en contexto, pero el modelo repitió clics y no completó niveles. Audito lo observado y el siguiente paso antes de gastar más GPU.
Resultado de la calibración
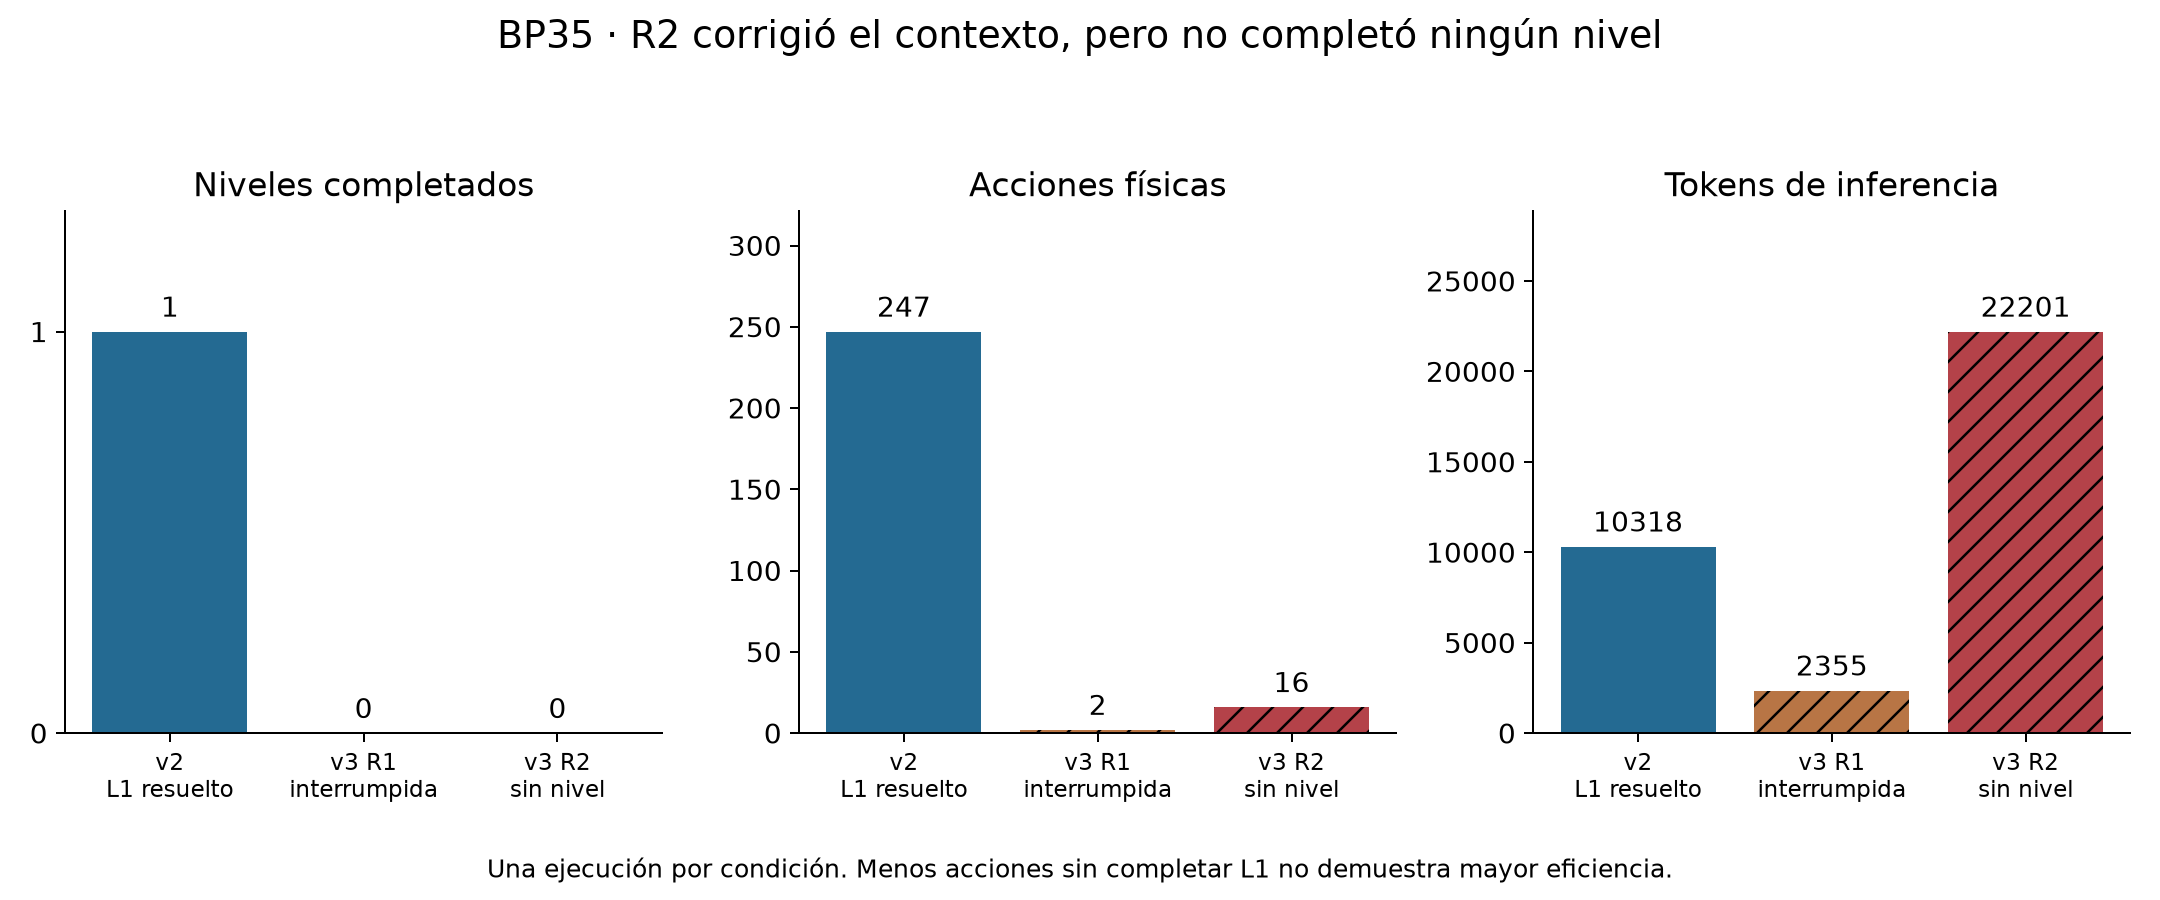
La segunda calibración GPU de ECHO-5.5-v3 terminó con cero niveles, 16 acciones físicas, ocho llamadas y 22.201 tokens. La scorecard del SDK oficial local fue cero; no hubo resets. Esto no mejora la v2, que sí alcanzó BP35 nivel 1 en 247 acciones. Tampoco es una evaluación completa del juego o una submission al leaderboard.
La corrección de contexto sí pasó; el comportamiento no
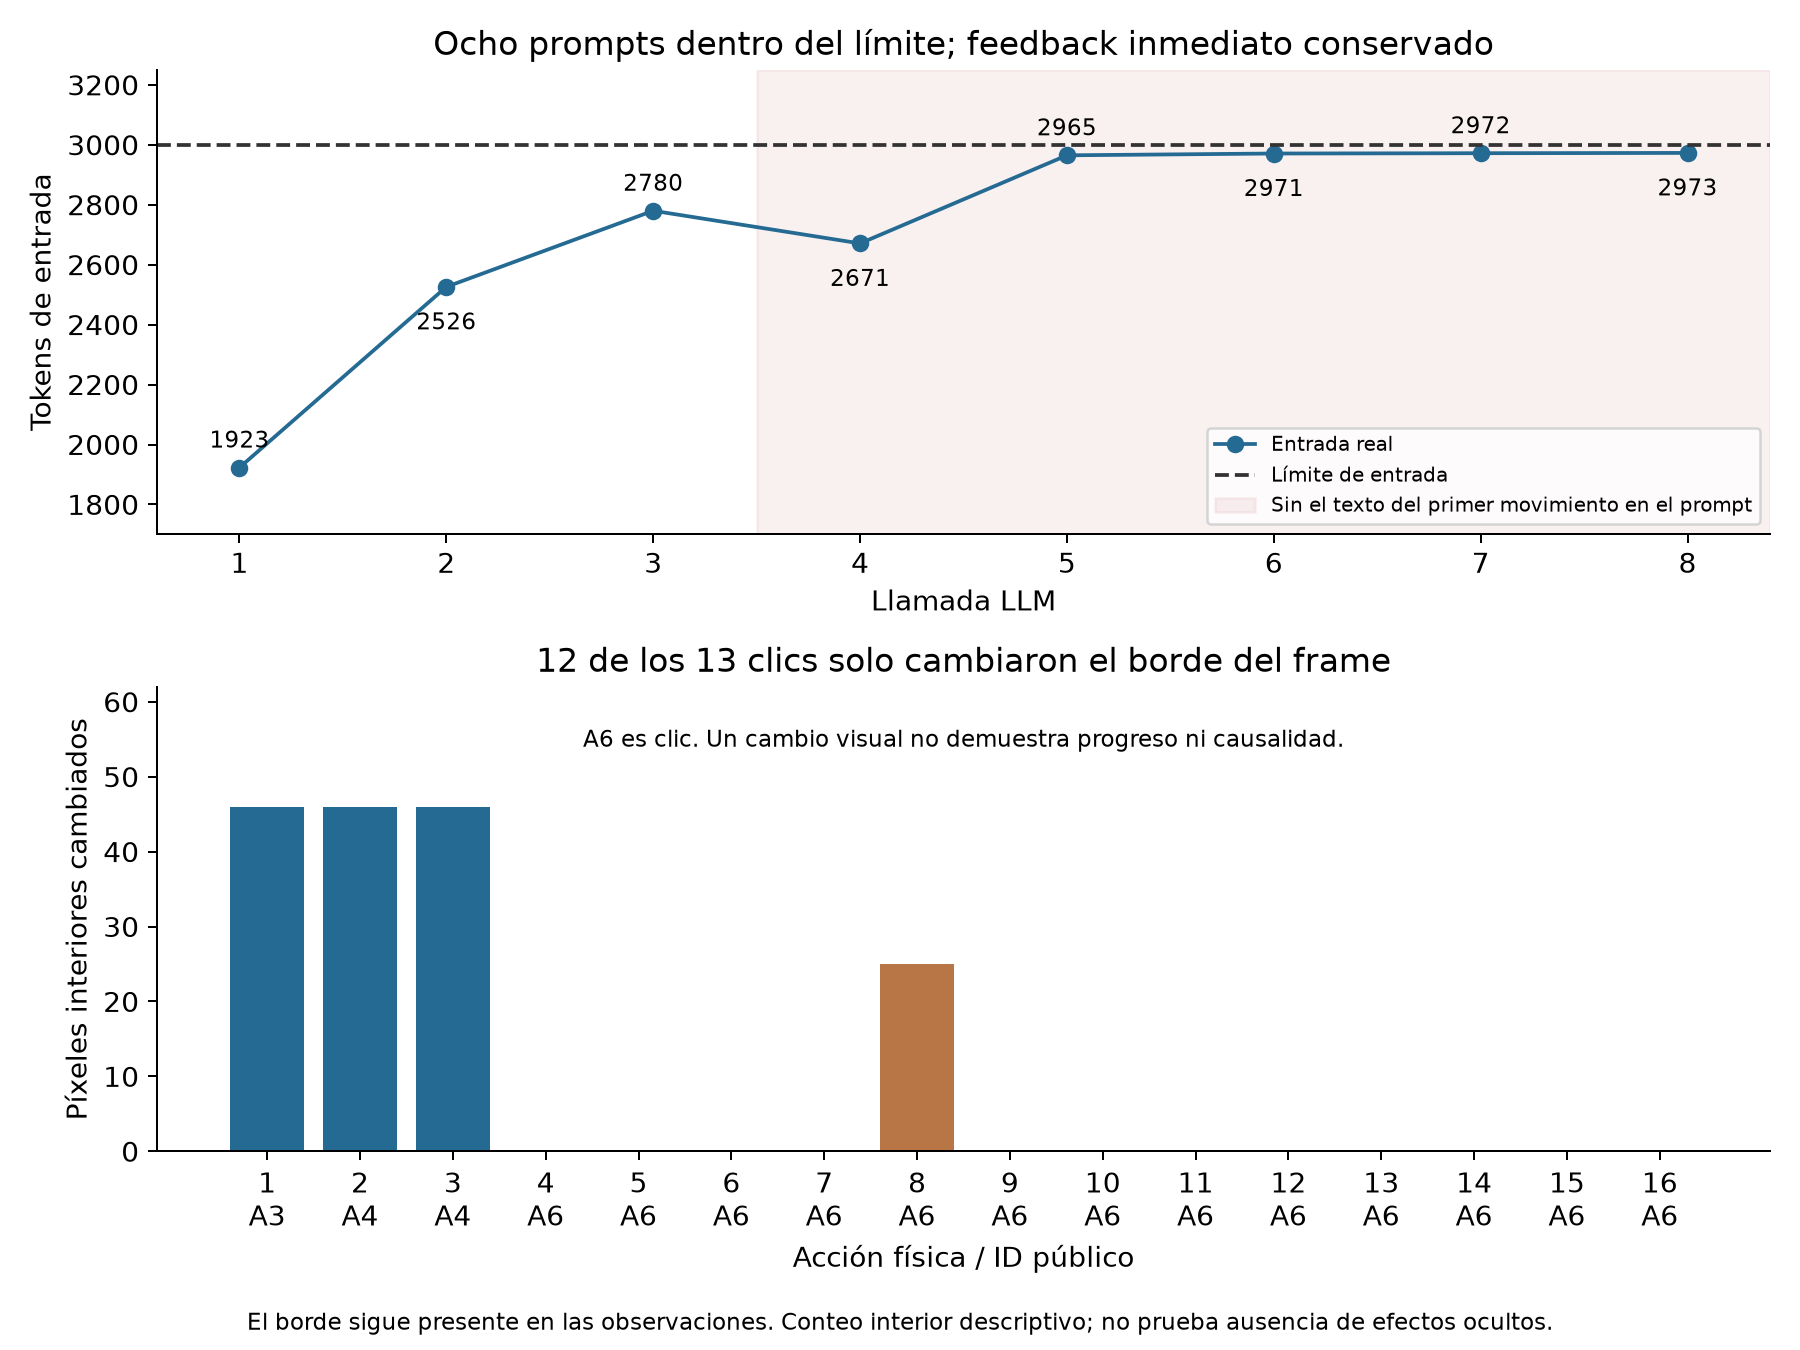
Los ocho prompts consumieron 1.923, 2.526, 2.780, 2.671, 2.965, 2.971, 2.972 y 2.973 tokens. El replay offline reconstruyó las plantillas y los tokens con hashes idénticos a los del relay. Se conservó el feedback del turno inmediatamente anterior en cada llamada. La corrección resolvió el desbordamiento de contexto reproducido en R1.
El modelo detectó al principio dos candidatos que se desplazaron seis y ocho píxeles. Después, la consulta de agencia reflejó solo la acción más reciente; una consulta vacía no significaba que el movimiento previo no hubiera ocurrido. Esa evidencia permanecía en los recibos, pero se perdió del resumen práctico. Los tres últimos programas fueron idénticos y repitieron clics. No hubo hipótesis o predicciones explícitas, ni llamadas a A*, exploración o zoom. No atribuyo al modelo un razonamiento que el registro no muestra.
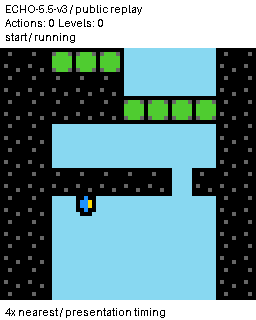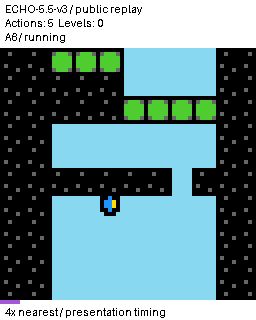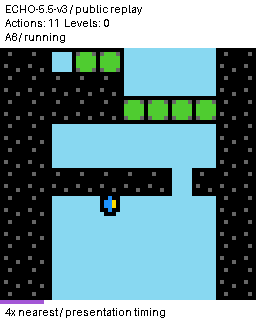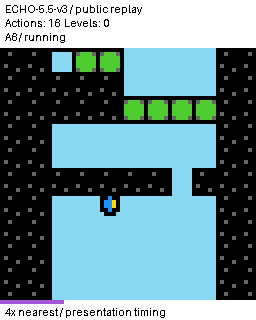
Doce de trece clics alteraron únicamente un píxel del borde; uno alteró también 25 píxeles interiores. No puedo afirmar que todos fueran inertes: puede haber efectos no visibles en el frame. Tampoco se probó ACTION7, que era legal. La calibración acabó al llegar al límite de ocho llamadas.
Repetición visual auditada
Custodia y límite de la evidencia
La auditoría encontró 90 recibos de eventos y dos de catálogo, 90 entradas del diario vinculadas, 17 frames públicos íntegros, cero reservas huérfanas y cero CAM destruidas. El trabajo remoto acabó y se apagaron relay y worker. Los MAC se verificaron localmente; el paquete público permite revisar hashes y consistencia, pero no contiene la clave para recalcular HMAC.
La siguiente prueba
Antes de otro episodio, propongo conservar un historial acotado de transiciones informativas —acción, antes/después, alcance temporal y recibo— separado del efecto de la última acción. También mostrar repeticiones sin progreso y etiquetar los candidatos situados en el borde sin eliminarlos automáticamente. En CPU se deben reconstruir los ocho prompts, mantener acceso al frame y probar que el modelo recibe la evidencia histórica correcta bajo 3.000 tokens. Solo si pasa esa puerta tiene sentido otra calibración BP35. No se amplía a otros juegos todavía.